
La combinaison gagnante tient en une formule simple : randomisation robuste, plan d’analyse pré-spécifié (SAP), correction de la multiplicité, traitement anticipé des données manquantes et analyses de sensibilité systématiques. Ces cinq réflexes éliminent la grande majorité des biais qui faussent les résultats de test A/B, car ils interviennent avant, pendant et après la collecte, là où les erreurs d’interprétation naissent habituellement.
En bref:
- La randomisation stratifiée et le plan d’analyse pré-spécifié sont essentiels pour limiter les biais liés à la sélection, à la mesure, à l’attrition ou aux événements externes.
- Un déséquilibre sur les variables clés, comme le device ou la source d’acquisition, indique souvent un biais de sélection compromettant la fiabilité du test.
- Il faut fixer une taille d’échantillon et une durée de test avant le début, en incluant des règles d’arrêt claires pour éviter la manipulation des résultats.
- La correction statistique des biais résiduels doit être prévue dans le SAP selon la nature de la problématique, notamment pour les tests multiples ou les déséquilibres.
- La contamination entre utilisateurs ou la saisonnalité peuvent falsifier les résultats, rendant nécessaire une planification rigoureuse, comme le rotation sur un cycle complet.
Table des matières
- Principaux types de biais qui affectent les tests A/B
- Comment détecter un biais caché dans vos résultats
- Concevoir un test A/B qui limite les biais dès le départ
- Corriger et quantifier l’effet des biais par l’analyse statistique
- Données manquantes, attrition et effet de mode
- Perspective pratique Lucioles : protocole type et checklist de vérifications
- L’effet de contagion entre utilisateurs fausse-t-il vos résultats ?
- Pourquoi la saisonnalité peut invalider un test A/B
- La dépendance intra-groupe, un piège souvent ignoré
- Régression vers la moyenne : le faux effet qui trompe tout le monde
- Ce que les guides théoriques oublient de dire sur les biais statistiques
- Accompagnement Lucioles pour sécuriser vos tests A/B
- Questions fréquentes
- Sources
Principaux types de biais qui affectent les tests A/B
Un biais statistique, c’est une déviation systématique entre ce que vous mesurez et la réalité, comme le rappelle l’addendum E9(R1) sur les estimands. Contrairement au bruit aléatoire, qui se dilue avec un échantillon plus grand, le biais persiste et oriente systématiquement vos conclusions dans une direction, souvent celle que vous espériez voir.
Dans un contexte de marketing digital, plusieurs familles de biais reviennent sans cesse :
- Biais de sélection : les visiteurs qui participent réellement au test diffèrent de votre audience cible, par exemple quand le trafic mobile est sous-représenté dans l’échantillon analysé.
- Biais de mesure : le mode de collecte influence le résultat observé, comme lorsqu’un changement d’outil de tracking modifie la façon dont les conversions sont comptées en cours de test.
- Biais d’attrition : les utilisateurs qui abandonnent avant la conversion ne sont pas répartis également entre les deux groupes.
- Biais temporel : une campagne marketing croisée ou un pic saisonnier avantage artificiellement une variante.
- Biais de multiplicité : tester trop d’indicateurs en parallèle augmente mécaniquement le risque de détecter un effet qui n’existe pas.
Ces biais se cumulent souvent. Un test lancé juste avant une opération commerciale combine facilement effet temporel et biais de sélection, ce qui rend l’interprétation du résultat brut pratiquement impossible sans contrôle supplémentaire.
Comment détecter un biais caché dans vos résultats
Certains signaux dans les données doivent déclencher une vérification immédiate, avant même de communiquer un résultat. Le premier réflexe consiste à contrôler l’équilibre entre vos groupes sur les variables qui comptent (device, source d’acquisition, ancienneté du visiteur).
Le D standardisé reste généralement faible quand les groupes sont bien équilibrés, et un ratio de variance compris entre 0,5 et 2 est généralement considéré comme acceptable, selon les recommandations de l’Insee sur l’effet de mode. Au-delà de ces seuils, l’équilibrage du test est compromis et toute lecture directe du résultat principal devient fragile.
D’autres signaux méritent votre attention :
- Un écart marqué entre segments (mobile contre desktop, trafic payant contre organique) qui ne se retrouve pas dans l’effet global.
- Un pic ou un creux brutal de performance coïncidant avec un événement externe, une promotion, une actualité ou une panne technique.
- Un arrêt anticipé du test dès qu’un seuil de signification est franchi, ou une vérification répétée des résultats plusieurs fois par semaine (le fameux « multiple peeking »).
- Un changement de métrique principale en cours de route, décidé après avoir observé les premières tendances.
Ces irrégularités ne prouvent pas toujours un biais, mais elles justifient systématiquement une relecture du protocole avant toute décision business.
Concevoir un test A/B qui limite les biais dès le départ
La meilleure façon de combattre un biais reste de l’empêcher d’apparaître. Cela se joue avant le lancement, au moment de la conception.
- Rédigez et verrouillez un SAP aligné sur votre estimand : définissez précisément ce que vous mesurez (l’effet moyen sur quelle population, sur quelle fenêtre temporelle) avant de regarder une seule donnée, conformément à la logique défendue par l’addendum E9(R1).
- Stratifiez la randomisation sur les variables qui influencent le comportement, comme le device ou le canal d’acquisition, pour éviter qu’un déséquilibre de hasard ne contamine le résultat.
- Calculez une taille d’échantillon et une durée de test fixes, en incluant une règle d’arrêt claire (voir notre guide sur la taille d’échantillon pour prioriser vos tests selon leur potentiel de gain).
- Définissez par avance le traitement des données manquantes et des valeurs extrêmes, avant toute ouverture des données, pour éviter les décisions arbitraires une fois les premiers chiffres visibles.
Conseil de pro : verrouillez votre SAP dans un document daté et partagé avant le lancement du test : cela évite toute tentation de réinterpréter les règles une fois les résultats connus.
Corriger et quantifier l’effet des biais par l’analyse statistique
Même avec un design soigné, certains biais résiduels nécessitent une correction au moment de l’analyse. Le choix de la méthode dépend du nombre d’hypothèses testées et de la nature du déséquilibre observé.
Face à la multiplicité des tests, deux familles de corrections s’opposent. Les corrections conservatrices comme Bonferroni réduisent fortement le risque de faux positif mais aussi la puissance statistique, tandis que le False Discovery Rate offre un meilleur compromis quand vous testez de nombreuses hypothèses exploratoires sur plusieurs métriques simultanément.
- La pondération par probabilité inverse (IPW) corrige un déséquilibre de participation, à condition que les variables qui expliquent ce déséquilibre soient mesurées.
- L’appariement rapproche les profils comparables entre groupes, mais réduit la taille de l’échantillon analysé et laisse ouverte la question des variables non observées.
- Les analyses de sensibilité, notamment la méthode de Rosenbaum ou le calcul d’un tipping point, testent la robustesse d’une conclusion face à un biais caché plausible.
| Méthode | Principe | Limite principale |
|---|---|---|
| Correction FDR | Contrôle la proportion de faux positifs parmi les résultats significatifs | Moins strict que Bonferroni sur chaque test individuel |
| Correction Bonferroni | Divise le seuil de signification par le nombre de tests | Perte de puissance statistique importante |
| IPW | Répondre les observations selon leur probabilité de participation | Inefficace si une variable clé n’est pas mesurée |
| Appariement | Compare des profils similaires entre groupes | Réduit la taille de l’échantillon utile |
| Analyse de sensibilité (Rosenbaum) | Teste la robustesse face à un biais caché hypothétique | Ne corrige pas le biais, le quantifie seulement |
Ces méthodes se complètent plutôt qu’elles ne se remplacent, et leur choix doit être pré-spécifié dans le SAP, jamais décidé après avoir vu les résultats.
Données manquantes, attrition et effet de mode
La non-réponse n’est jamais neutre par défaut. Elle se classe en trois catégories : complètement aléatoire (MCAR), aléatoire conditionnellement à des variables observées (MAR), ou non ignorable (MNAR), cette dernière étant la plus dangereuse puisqu’elle dépend de la variable que vous mesurez elle-même.
- Une imputation simple convient pour du MCAR, mais devient trompeuse en présence de MNAR sans correction spécifique.
- L’analyse en intention de traiter (ITT) garde tous les participants initiaux, tandis que l’analyse per-protocol exclut les abandons, ce qui peut introduire un biais de sélection si l’abandon n’est pas aléatoire.
- Un essai croisé AB/BA étudié par l’Insee montre qu’une analyse de sensibilité de type Rosenbaum permet de détecter un effet de mode caché derrière une non-réponse non ignorable.
- Un test pilote sur un petit sous-échantillon aide à calibrer vos règles d’imputation avant le lancement à grande échelle, une pratique recommandée par le guide méthodologique de l’ENCePP.
Perspective pratique Lucioles : protocole type et checklist de vérifications
Dans nos missions d’audit et d’accompagnement sur l’optimisation du taux de conversion de parcours clients, nous appliquons une checklist avant chaque test, quel que soit le secteur du client.
- Le SAP est rédigé et daté avant toute collecte de données.
- La randomisation est stratifiée sur device et canal d’acquisition, avec un contrôle d’équilibrage.
- La taille d’échantillon et la règle d’arrêt sont fixées.
- Le plan de gestion des données manquantes est écrit avant l’ouverture du tableau de résultats.
- Un rapport d’analyse de sensibilité accompagne la conclusion finale.
Conseil de pro : automatisez le calcul du D standardisé et du ratio de variance dans votre tableau de bord de test : un contrôle qui prend trente secondes évite des semaines de décisions prises sur un résultat biaisé.
Nos services d’audit et d’accompagnement UX intègrent cette rigueur méthodologique à chaque étape d’optimisation de parcours client.
L’effet de contagion entre utilisateurs fausse-t-il vos résultats ?
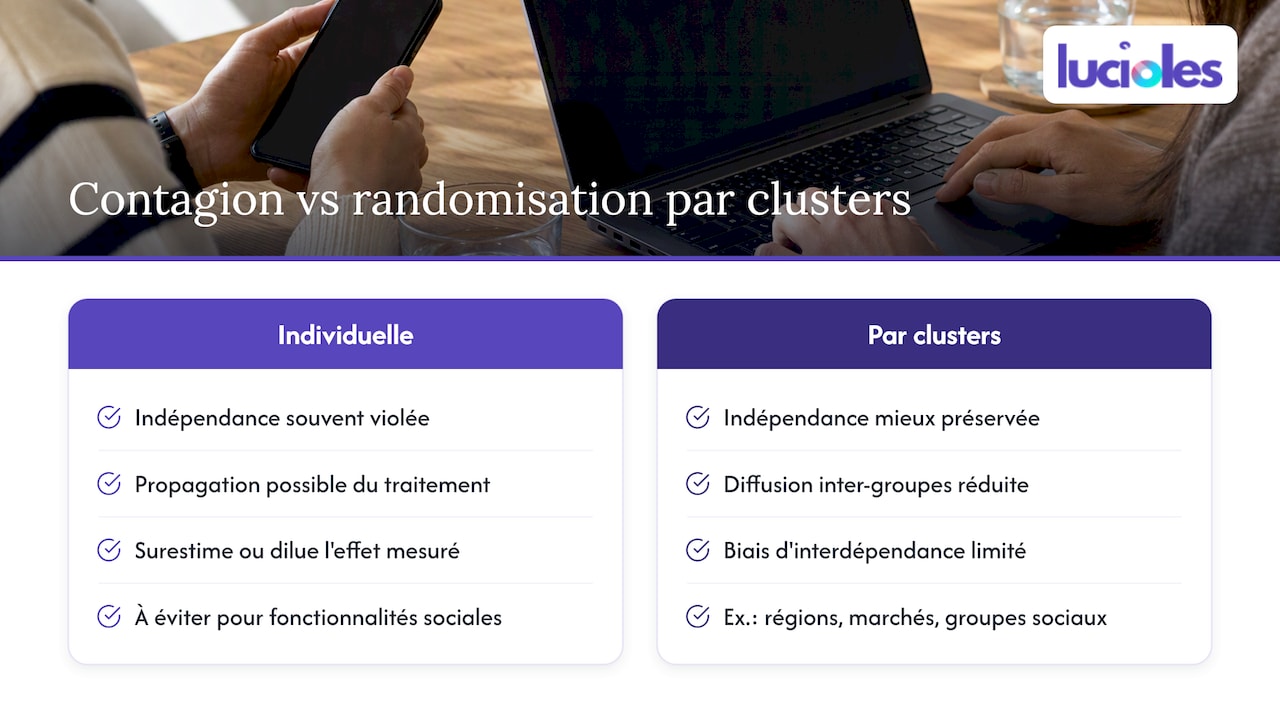
Quand les utilisateurs d’un même test interagissent entre eux, l’hypothèse d’indépendance qui sous-tend la plupart des tests statistiques classiques s’effondre. C’est typiquement le cas des fonctionnalités sociales, des programmes de parrainage ou des marketplaces où un utilisateur du groupe test peut influencer le comportement d’un utilisateur du groupe contrôle.
Ce phénomène, parfois appelé contamination de traitement, biaise l’estimation de l’effet dans les deux sens. Il peut gonfler artificiellement l’effet mesuré si l’exposition au traitement se diffuse au groupe contrôle par imitation, ou au contraire le diluer si les deux groupes finissent par converger vers un comportement similaire.
La solution la plus robuste consiste à randomiser au niveau du cluster plutôt qu’au niveau individuel, qu’il s’agisse d’une zone géographique, d’un marché ou d’un groupe social identifiable. Quand ce n’est pas possible, documenter l’ampleur probable de la contagion dans le SAP permet au moins d’interpréter le résultat avec la prudence nécessaire plutôt que de le traiter comme un effet causal propre. Dans un test de fonctionnalité virale ou de programme de fidélité, ignorer cette interdépendance revient à surestimer systématiquement l’impact réel d’une variante.
Pourquoi la saisonnalité peut invalider un test A/B
Un test lancé sur deux semaines captera rarement la même réalité business qu’un test lancé sur deux mois. Les variations temporelles, qu’elles soient hebdomadaires, mensuelles ou liées à un événement commercial, interagissent souvent avec la variante testée d’une façon qui n’apparaît pas dans l’effet moyen global.
Un exemple fréquent en e-commerce : une nouvelle page produit testée pendant une période de soldes affichera un taux de conversion gonflé pour les deux groupes, rendant la comparaison entre variantes peu fiable si le volume de trafic promotionnel diffère entre eux. De la même façon, un test qui chevauche un changement de campagne marketing capte un effet mélangé, impossible à attribuer clairement à la variante elle-même.
La parade la plus simple reste de faire tourner le test sur un cycle complet, généralement au moins une semaine entière répétée plusieurs fois, pour neutraliser les écarts jour par jour. Pour les activités à forte saisonnalité, comparer les variantes sur des périodes équivalentes d’une année sur l’autre, plutôt que sur une fenêtre calendaire fixe, réduit le risque de confondre un effet de saison avec un effet de produit. Ce point rejoint directement la nécessité de fixer une durée de test dans le SAP plutôt que de la décider en cours de route selon l’avancement des résultats.
La dépendance intra-groupe, un piège souvent ignoré
La plupart des calculs de signification statistique supposent que chaque observation est indépendante des autres. Cette hypothèse se vérifie rarement en pratique dès qu’un même utilisateur génère plusieurs sessions, plusieurs clics ou plusieurs achats pendant la durée du test.
Si vous comptez chaque session comme une observation distincte alors qu’elle provient d’un nombre plus restreint d’utilisateurs uniques, vous gonflez artificiellement la taille effective de votre échantillon. Le résultat : un intervalle de confiance trop étroit et un seuil de signification atteint alors que l’effet réel reste incertain.
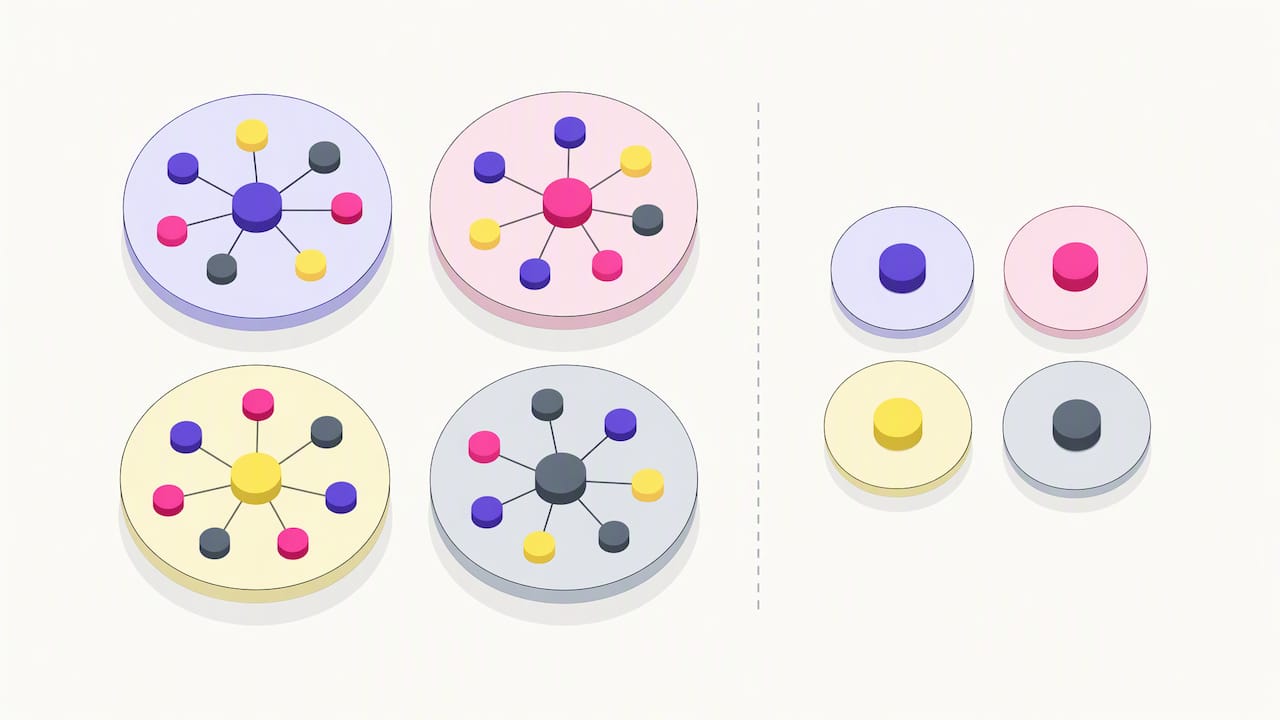
Cette dépendance intra-groupe touche particulièrement les tests B2B, où un petit nombre de comptes génère un volume disproportionné d’interactions, ou les tests sur des utilisateurs connectés qui reviennent plusieurs fois pendant la fenêtre d’observation. La correction standard consiste à agréger au niveau de l’unité réellement indépendante, l’utilisateur plutôt que la session, ou à utiliser des modèles qui tiennent compte explicitement de cette structure en grappes. Ignorer ce point conduit à annoncer des résultats significatifs qui ne résistent pas à une relecture rigoureuse, un écueil que toute équipe data devrait vérifier avant de communiquer une victoire statistique.
Régression vers la moyenne : le faux effet qui trompe tout le monde
Quand vous sélectionnez une page ou une audience parce qu’elle affichait une performance exceptionnellement basse avant le test, une partie de l’amélioration observée après changement provient simplement d’un retour naturel vers la moyenne, indépendamment de toute action corrective.
Ce phénomène touche particulièrement les tests lancés en réaction à une mauvaise performance ponctuelle : une landing page dont le taux de conversion a chuté une semaine donnée, un email dont le taux d’ouverture a particulièrement déçu. Une partie du rebond observé ensuite aurait eu lieu même sans intervention, simplement parce que les valeurs extrêmes tendent statistiquement à se rapprocher de leur moyenne habituelle au fil du temps.
La parade consiste à comparer la performance post-test à une moyenne de référence calculée sur une période suffisamment longue, plutôt qu’au seul point bas qui a motivé le lancement du test, et à inclure un groupe contrôle qui subit exactement la même dynamique temporelle sans recevoir le traitement. Sans ce contrôle, il devient impossible de distinguer l’effet réel de la variante du simple retour à la normale, ce qui explique une partie des résultats de test qui ne se reproduisent jamais en conditions réelles.
Ce que les guides théoriques oublient de dire sur les biais statistiques
La plupart des ressources sur les biais en A/B testing s’arrêtent à la théorie : définitions, taxonomies, formules. Ce qu’elles passent sous silence, c’est que la rigueur méthodologique coûte du temps et ralentit la cadence de test, ce qui pousse beaucoup d’équipes à la sacrifier sous pression commerciale.
Notre conviction, après avoir observé des dizaines de protocoles d’expérimentation : la correction statistique la plus sophistiquée ne compense jamais un SAP rédigé après coup. L’ordre des opérations compte plus que la finesse de la méthode choisie. Une équipe qui verrouille son plan d’analyse avant de voir une donnée, même avec une correction simple, obtient des résultats plus fiables qu’une équipe équipée des meilleurs outils statistiques mais qui ajuste ses hypothèses en cours de route.
La priorité absolue n’est donc pas d’apprendre la méthode de Rosenbaum. C’est de changer l’habitude de décision : écrire, dater et partager le protocole avant le lancement. Tout le reste, randomisation stratifiée, corrections de multiplicité, analyses de sensibilité, ne fait que renforcer une discipline qui doit exister en amont.
— Vincent
Accompagnement Lucioles pour sécuriser vos tests A/B
Fiabiliser une démarche d’expérimentation demande du temps que peu d’équipes marketing ont en interne. Nos missions d’audit et d’accompagnement de parcours clients intègrent la rédaction de SAP, la stratification de la randomisation et les analyses de sensibilité dans chaque protocole de test.
Nos agents IA d’automatisation prennent aussi en charge les contrôles d’équilibrage récurrents, pour que votre équipe se concentre sur l’interprétation plutôt que sur la vérification manuelle. Contactez-nous pour un audit de votre protocole de test actuel.
Questions fréquentes
C’est quoi l’A/B testing ?
L’A/B testing consiste à comparer deux versions d’un élément (page, email, fonctionnalité) auprès de deux groupes d’utilisateurs distincts pour mesurer laquelle performe le mieux sur un indicateur défini à l’avance. La fiabilité du résultat dépend directement de la qualité de la randomisation et du plan d’analyse fixé avant le lancement.
Qu’est-ce qu’un biais statistique ?
Un biais statistique est une déviation systématique entre la valeur mesurée et la valeur réelle d’un effet, comme le définit l’addendum E9(R1). Contrairement au bruit aléatoire, il ne disparaît pas avec un échantillon plus grand et oriente systématiquement la conclusion dans une direction donnée.
Quels sont les différents types de tests statistiques ?
Les tests A/B reposent le plus souvent sur des tests de proportion ou des tests t selon la nature de la métrique mesurée, complétés par des corrections de multiplicité (FDR, Bonferroni) quand plusieurs hypothèses sont testées en parallèle. Le choix dépend de la distribution des données et du nombre de comparaisons effectuées simultanément.
Qu’est-ce que la méthode de testing ?
Une méthode de testing fiable combine randomisation stratifiée, plan d’analyse pré-spécifié et règles d’arrêt fixées avant le lancement, pour éviter toute décision prise après avoir observé les premiers résultats. Les recommandations de l’ENCePP insistent notamment sur la spécification complète du traitement des données manquantes avant l’ouverture des résultats.
Comment détecter un biais de sélection dans un test A/B ?
Un biais de sélection se repère en comparant l’équilibre des groupes sur les variables clés, à l’aide d’indicateurs comme le D standardisé ou le ratio de variance décrits par l’Insee. Un déséquilibre marqué sur ces mesures signale que la participation au test n’était pas purement aléatoire.
Sources
- E9(R1) addendum on estimands and sensitivity analysis (EMA)
- Chapter 12: Statistical analyses – ENCePP methodological guide
- L’effet de mode : mesure et correction (INSEE presentation)
