
Gardez un test A/B au moins un cycle hebdomadaire complet, soit 7 à 14 jours, puis continuez jusqu’à atteindre la puissance et le niveau de confiance que vous vous êtes fixés. La durée exacte dépend de votre trafic, de votre taux de conversion de départ et de la taille d’effet que vous cherchez à détecter : un petit site aura besoin de plusieurs semaines là où un gros volume peut conclure en quelques jours.
En bref:
- Prévoyez au moins 7 à 14 jours, puis calculez la durée selon le trafic, le taux de conversion et l’effet minimal à détecter.
- Pour une décision commerciale, visez généralement 95 % de confiance et 80 % de puissance ; les vérifications quotidiennes répétées augmentent le risque de faux positifs.
- Validez d’abord le suivi des événements par un test A/A ; n’interprétez pas les premiers jours, sensibles à l’effet de nouveauté.
- Quand l’achat est trop rare, mesurez une action intermédiaire plus fréquente ; regroupez des tests seulement si leurs hypothèses restent cohérentes.
- Avec un historique riche, l’ajustement par régression peut parfois réduire de moitié l’échantillon requis ; l’analyse séquentielle permet un suivi continu sans fausser les résultats.
Table des matières
- Quels critères statistiques indiquent qu’il est temps d’arrêter ?
- Comment calculer la durée nécessaire selon votre trafic et votre objectif
- Pourquoi les effets de nouveauté faussent les résultats trop précoces
- Accélérer un test sans sacrifier la rigueur statistique
- Que faire quand votre trafic ne suffit pas à détecter l’effet visé
- Comment nous calibrons la durée d’un test A/B sur le terrain
- Un accompagnement pour structurer vos tests A/B et leur durée
- Questions fréquentes
- Sources
Quels critères statistiques indiquent qu’il est temps d’arrêter ?
Deux notions gouvernent la décision d’arrêt : le niveau de confiance et la puissance statistique. La puissance, généralement visée à 80 %, mesure votre capacité à détecter un effet réel quand il existe. Plus vous exigez ces deux seuils élevés, plus l’échantillon nécessaire grandit, et donc plus le test doit durer.
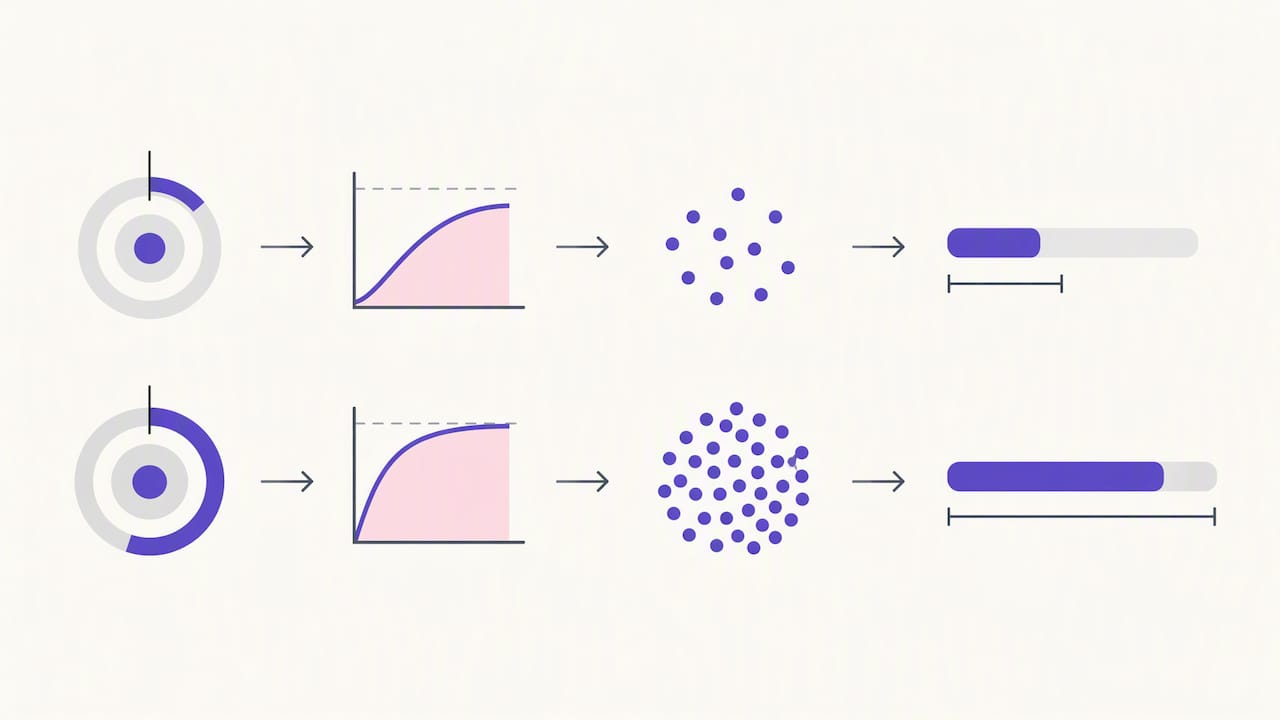
Un piège classique consiste à regarder les résultats chaque jour et à arrêter dès que la p-value franchit le seuil, une pratique connue sous le nom de « peeking ». Cette habitude gonfle artificiellement le taux de faux positifs, car chaque regard supplémentaire est une nouvelle chance de tomber sur un résultat significatif par hasard. Les recommandations de plateformes d’expérimentation rappellent qu’abaisser le seuil de confiance réduit le temps requis mais augmente mécaniquement ce risque, et que modifier ce paramètre en cours de route affecte instantanément les expériences actives.
Avant d’interpréter quoi que ce soit, deux vérifications s’imposent :
- Lancer un test A/A pour confirmer que votre système ne détecte pas de différence là où il n’y en a pas.
- Auditer le logging pour s’assurer que les événements sont comptés correctement des deux côtés.
Ces étapes de validation, documentées dans les bonnes pratiques de systèmes d’expérimentation, évitent de bâtir une décision commerciale sur une fuite de données ou un bug de tracking.
L’intervalle de confiance autour de votre résultat vaut souvent plus qu’une simple p-value binaire : il montre l’amplitude probable de l’effet réel, ce qui aide à juger si une victoire statistique représente aussi une victoire business.
Comment calculer la durée nécessaire selon votre trafic et votre objectif
La taille d’échantillon requise dépend de trois éléments : votre taux de conversion actuel, la plus petite amélioration que vous jugez utile de détecter, et les seuils de confiance et de puissance choisis. Sans entrer dans les formules, le principe est simple : plus l’effet que vous cherchez est petit, plus il faut d’observations pour le distinguer du bruit statistique. Une calculatrice de taille d’échantillon fait ce calcul à votre place une fois ces trois paramètres renseignés.
- Notez votre taux de conversion actuel et la taille d’effet minimale qui justifierait un déploiement.
- Fixez confiance et puissance, typiquement 95 % et 80 % pour la plupart des décisions commerciales.
- Convertissez la taille d’échantillon obtenue en jours à partir de votre trafic quotidien par variante.
- Arrondissez toujours au cycle hebdomadaire supérieur pour capturer les variations de comportement selon les jours.
Voici trois profils de trafic illustratifs, à titre d’exemple de calcul :
Ces chiffres sont des ordres de grandeur pédagogiques : le calcul réel dépend toujours de votre taux de base exact et de l’effet visé.
Le choix de votre indicateur de succès change tout. Une conversion binaire présente une variance bien plus faible qu’un indicateur de revenu, ce qui réduit fortement la taille d’échantillon nécessaire : détecter un effet sur le taux de conversion demande en général beaucoup moins d’observations que détecter le même effet relatif sur le revenu moyen par visiteur. Pour prioriser vos tests, classez-les par potentiel d’impact et par facilité de mise en œuvre, en gardant toujours une métrique principale stable plutôt qu’un cocktail d’indicateurs secondaires.
Pourquoi les effets de nouveauté faussent les résultats trop précoces
Quand vous changez une interface, une partie de vos visiteurs réguliers réagit simplement au changement, pas au mérite réel de la nouvelle version : c’est l’effet de nouveauté. À l’inverse, l’effet de primauté pousse certains utilisateurs habitués à l’ancienne version à moins bien performer sur la nouvelle le temps de s’adapter. Ces deux biais se dissipent avec le temps, ce qui explique pourquoi un verdict pris après deux ou trois jours peut s’inverser complètement une semaine plus tard.
Pour s’en prémunir :
- Segmentez vos résultats par semaine et comparez les tendances entre nouveaux visiteurs et visiteurs récurrents.
- Visualisez l’évolution quotidienne de votre métrique principale plutôt que de ne regarder que le cumul final.
- Relancez un test A/A en parallèle si vous suspectez une dérive technique plutôt qu’un effet comportemental.
Conseil de pro : Ne tranchez jamais sur la base des trois ou quatre premiers jours, même si l’écart semble spectaculaire : laissez le temps aux habitudes de se stabiliser avant de lire le résultat comme définitif.
Accélérer un test sans sacrifier la rigueur statistique
Deux approches permettent de conclure plus vite sans augmenter le risque de conclusion erronée. La première, l’analyse séquentielle anytime-valid, utilise des « confidence sequences » qui restent valables à tout moment de l’observation, ce qui autorise un suivi continu et un arrêt dès que le seuil est atteint, sans le gonflement de faux positifs que provoque le peeking classique. Les travaux de recherche sur l’analyse séquentielle et l’ajustement par régression montrent que ces garanties time-uniform réduisent le nombre d’observations nécessaires pour conclure.
La seconde approche consiste à ajuster les résultats par régression en tenant compte de variables mesurées avant le traitement, comme le comportement passé d’un visiteur. Cette méthode diminue la variance résiduelle et peut réduire d’environ la moitié le nombre d’observations nécessaires dans certains cas documentés, notamment lors d’applications industrielles à grande échelle.
- Les plateformes disposant d’historiques riches sur leurs utilisateurs tirent le meilleur parti de ces ajustements.
- Les équipes qui surveillent leurs tests en continu bénéficient le plus des méthodes anytime-valid.
Les procédures anytime-valid et l’ajustement par régression peuvent fournir des garanties time-uniform et réduire le nombre d’observations nécessaires pour conclure un test.
Que faire quand votre trafic ne suffit pas à détecter l’effet visé
Un trafic trop faible pour votre métrique principale ne signifie pas qu’il faut renoncer à tester. Privilégiez les micro-conversions, comme une inscription à une newsletter ou un ajout au panier, qui se produisent plus fréquemment que l’achat final et accélèrent la détection d’un signal.
- Mesurez une micro-conversion à plus fort volume plutôt que la conversion finale si celle-ci est trop rare pour votre trafic.
- Envisagez le pooling de tests similaires pour cumuler de la puissance, en gardant à l’esprit que regrouper des expériences augmente le risque d’hétérogénéité si les hypothèses ne sont pas documentées.
- Complétez par des méthodes qualitatives, entretiens utilisateurs ou tests modérés, quand le volume quantitatif reste hors de portée.
- Avant de lancer, vérifiez systématiquement trafic disponible, taille d’effet réaliste et cohérence de votre tracking.
Comment nous calibrons la durée d’un test A/B sur le terrain
Un test A/A et un audit de logging précèdent systématiquement le lancement, pour éviter de bâtir une recommandation sur une donnée biaisée. Quand le trafic du client le permet, nous privilégions l’analyse séquentielle pour raccourcir les délais de décision sans sacrifier la rigueur ; sur les comptes à trafic plus modeste, nous allongeons la fenêtre d’observation et combinons les signaux quantitatifs avec des entretiens utilisateurs.
— Vincent
Un accompagnement pour structurer vos tests A/B et leur durée
Définir la bonne durée de test suppose de bien poser le calcul de taille d’échantillon, le choix de l’indicateur de succès et le protocole de validation en amont, des étapes que nous intégrons dans notre offre Optimisation de parcours client. Nos audits CRO identifient les hypothèses à plus fort potentiel avant même de parler de durée, pour que chaque semaine de test serve une décision qui compte vraiment.
Concrètement, un accompagnement avec nous comprend un programme d’accompagnement intensif pour freelances qui propose des scripts de prospection personnalisés et un suivi de résultats pour structurer vos actions commerciales.
- Un calcul de taille d’échantillon adapté à votre trafic réel et à votre taux de conversion actuel.
- Un plan expérimental complet avec protocole A/A et vérification du logging avant lancement.
- Des recommandations d’indicateur de succès pour réduire la variance et accélérer la détection.
- Un suivi structuré permettant d’envisager l’analyse séquentielle quand votre volume le justifie.
Si vous voulez transformer vos tests A/B en décisions fiables plutôt qu’en pari hebdomadaire, contactez notre équipe pour un audit de votre parcours de conversion.
Questions fréquentes
C’est quoi le A/B testing ?
Le A/B testing consiste à présenter deux versions d’une page ou d’un parcours à des visiteurs répartis aléatoirement, puis à comparer leurs résultats sur une métrique précise comme le taux de conversion. La version qui obtient un résultat statistiquement meilleur, confirmé par un niveau de confiance suffisant, devient la référence déployée à tous les visiteurs.
Quels sont les niveaux de test en expérimentation digitale ?
Les équipes CRO distinguent généralement les tests sur un seul élément, les tests multivariés qui combinent plusieurs variations simultanément, les tests de parcours complet qui modifient plusieurs pages, et les tests de bout en bout qui couvrent l’intégralité du tunnel de conversion.
Qu’est-ce qu’un test de bout en bout ?
Un test de bout en bout évalue l’intégralité d’un parcours utilisateur, de la première visite jusqu’à la conversion finale, plutôt qu’un seul élément isolé comme un bouton ou un titre. Il demande généralement un trafic plus important et une durée plus longue qu’un test ponctuel, car il doit capter l’effet cumulé de plusieurs interactions.
Quel outil choisir pour suivre un test A/B gratuitement ?
Plusieurs plateformes comme Firebase A/B Testing proposent un suivi gratuit avec recommandation de durée minimale, généralement deux semaines pour un test sur la configuration à distance. Le choix dépend surtout de votre pile technique existante et du volume de trafic à traiter, plus que du prix de l’outil lui-même.
Combien de temps minimum faut-il pour un test A/B fiable ?
La durée minimale recommandée est d’un cycle hebdomadaire complet, soit 7 à 14 jours, pour capturer les variations de comportement entre les jours de semaine et le week-end. Au-delà de ce minimum, la durée exacte dépend de votre trafic, de votre taux de conversion de départ et de la taille d’effet que vous cherchez à détecter.
Sources
- Firebase A/B Testing — Experiment duration
- Elements of an Experimentation System — Encyclopedia of ML & DM (Kohavi et al.)
- Controlled experiments on the web: survey and practical guide (Springer)
- Sequential analysis and regression adjustment — HBS working paper
