
La significativité d’un A/B test indique si l’écart observé entre votre version A et votre version B est assez grand pour ne pas être attribué au hasard. Avec le seuil usuel de 0,05, une p-value inférieure à 0,05 signale une différence statistiquement significative. Mais ce chiffre ne dit ni si l’écart est rentable, ni si vous pouvez arrêter le test aujourd’hui. Voici comment le lire, le calculer et décider avec lui.
En bref
- La significativité mesure le hasard, pas le gain. Elle chiffre la probabilité d’observer un écart au moins aussi grand si, en réalité, les deux versions étaient identiques.
- Le seuil courant est 0,05, soit un niveau de confiance de 95 %. Il tolère donc environ 5 % de faux positifs.
- Ne stoppez jamais un test dès que la p-value passe sous 0,05. Chaque coup d’œil intermédiaire augmente le risque de déclarer un faux gagnant.
- Fixez à l’avance l’échantillon et la durée, à partir du taux de référence, de l’effet visé, de alpha et de la puissance.
- Un résultat significatif doit aussi être pertinent: l’effet doit justifier le coût de la décision.
Table des matières
- Ce que la significativité statistique veut vraiment dire
- Quel test statistique se cache derrière votre outil
- Interpréter un résultat : p-value, intervalle de confiance, effet
- Significativité statistique et impact réel : deux questions distinctes
- Le piège n°1 : arrêter le test dès que c’est « vert »
- Calculer l’échantillon et la durée avant de lancer
- Le test A/A : vérifier que votre outil ne vous ment pas
- Perspective : notre façon de rendre un test décisionnel
- Votre check-list avant de déclarer un gagnant
- Passer de la théorie à des tests qui rapportent
- FAQ
- Sources
Ce que la significativité statistique veut vraiment dire
Imaginez que vous lanciez deux versions d’une page produit, strictement identiques. Même sans aucune différence réelle, leurs taux de conversion ne seront jamais exactement égaux : le hasard de l’échantillonnage crée de petits écarts. La significativité sert à faire le tri entre ce bruit et un vrai signal.
Techniquement, elle mesure la probabilité d’observer une différence de performance au moins aussi grande si l’effet réel est nul. Cette probabilité s’appelle la p-value. On la compare à un seuil fixé avant le test, appelé alpha.
La p-value en une phrase
La p-value répond à une seule question : « si A et B étaient identiques, quelle serait la chance de voir un écart aussi extrême que celui-ci ? » Une p-value de 0,03 signifie : 3 % de chances. Ce n’est pas la probabilité que B soit meilleur, et ce n’est pas la probabilité de vous tromper en choisissant B. C’est une probabilité calculée dans l’hypothèse où il n’y a aucun effet.
Le seuil de 0,05 et le niveau de confiance de 95 %
Dans Firebase A/B Testing, le seuil de significativité est fixé à 0,05 : en dessous, la différence est jugée significative, au-dessus, non significative. Adobe Target précise qu’un alpha de 5 % correspond à un niveau de confiance de 95 %, mais qu’il implique aussi qu’un test puisse signaler à tort une différence dans 5 % des expériences où il n’y en a aucune.
Retenez cette conséquence : si vous menez vingt tests sur des variantes sans effet, un en moyenne paraîtra gagnant. Le seuil n’élimine pas l’erreur, il la cadre.
Quel test statistique se cache derrière votre outil
Votre outil d’A/B testing calcule la p-value à votre place, mais le test employé dépend du type d’indicateur.
| Type d’indicateur | Exemple | Test généralement utilisé |
|---|---|---|
| Binaire (converti / non converti) | Taux de conversion, taux de clic | Test z de proportions |
| Continu | Revenu par visiteur, panier moyen | Test t à variances inégales (Welch) |
Cette répartition est celle que documente Firebase : test z de proportions pour une conversion binaire, test t à variances inégales pour une variable continue comme le revenu. La littérature va dans le même sens : le test t de Student ou de Welch figure parmi les tests d’hypothèse les plus courants pour évaluer un A/B test, et la revue systématique recense aussi le bootstrap, le chi carré, les corrections de Bonferroni, les méthodes bayésiennes et des régressions comme CUPED.
Autre point de fond : pour des échantillons suffisamment grands, l’approximation normale est généralement utilisée pour comparer l’effet du traitement entre deux groupes. Ces méthodes supposent aussi que la réponse d’un visiteur ne dépend pas de la version affichée aux autres, l’hypothèse dite SUTVA, rappelée dans cette même revue. Dans un test classique de page, elle tient presque toujours. Elle devient fragile quand vos visiteurs s’influencent, par exemple sur une place de marché ou un réseau social.
Pour approfondir les pièges de mesure, notre article sur les biais statistiques en A/B testing détaille ceux à repérer avant d’interpréter un résultat.
Interpréter un résultat : p-value, intervalle de confiance, effet
Un bon rapport de test se lit en trois temps. La p-value seule ne suffit pas.
- La p-value : est-elle sous votre seuil, fixé avant le test ?
- L’intervalle de confiance : quelle est la fourchette plausible de l’écart réel ? SurveyMonkey recommande d’examiner ensemble la statistique t, la p-value et l’intervalle de confiance plutôt que de tout réduire à un seuil.
- La taille de l’effet : l’écart, même réel, vaut-il l’investissement ?
Illustration chiffrée
Prenons un exemple fictif. Votre page de référence convertit à 3,0 %. La variante affiche 3,3 %, soit +10 % en relatif. L’outil indique une p-value de 0,04 et un intervalle de confiance sur l’écart relatif allant de +0,5 % à +19,5 %.
- La p-value est sous 0,05 : le résultat est significatif.
- L’intervalle est large : le vrai gain peut être minuscule ou très important.
- Si le gain réel tombe à +0,5 %, la mise en production vaut-elle le coût de développement ?
C’est là que le raisonnement business reprend la main. Pour chiffrer cette décision, voyez notre guide pour décider vos tests A/B en euros, qui relie taille d’échantillon et priorisation à l’enjeu financier.
Un résultat non significatif ne veut pas dire « pas d’effet »
Un résultat non significatif peut signifier que l’effet est trop faible pour être détecté ou que l’échantillon est trop petit. C’est une absence de preuve, pas une preuve d’absence. Dans ce cas, l’intervalle de confiance aide à mesurer l’incertitude restante : s’il est étroit et centré sur zéro, vous pouvez classer l’idée sans regret. S’il est large, le test n’a simplement pas assez de données pour trancher.
Significativité statistique et impact réel : deux questions distinctes
Une petite p-value prouve que l’écart est probablement réel. Elle ne prouve pas qu’il est important. SurveyMonkey rappelle qu’un effet se juge par sa preuve statistique et par sa pertinence pratique : une petite p-value ne suffit pas à justifier une décision coûteuse.
Posez-vous donc ces quatre questions avant de déployer :
- Quel gain en euros par mois représente l’extrémité basse de l’intervalle ?
- Ce gain couvre-t-il le coût de mise en production et de maintenance ?
- L’indicateur testé est-il bien celui qui compte (ventes, leads qualifiés) et non un simple clic ?
- Le résultat est-il cohérent sur les segments importants (mobile, desktop, nouveaux visiteurs) ?
Pour relier ces chiffres à votre rentabilité globale, notre guide pour mesurer le ROI du marketing digital donne le cadre de calcul.
Le piège n°1 : arrêter le test dès que c’est « vert »
C’est l’erreur la plus répandue, et la plus coûteuse. Le tableau de bord passe au vert au bout de quatre jours, l’équipe est enthousiaste, on coupe. Le problème : chaque consultation intermédiaire est une nouvelle occasion de franchir le seuil par hasard.
Dans la simulation A/A publiée par Wish, le taux de faux positifs est passé d’environ 4,7 % avec une décision à taille d’échantillon fixe à environ 21 % avec un arrêt au premier p<0,05. Autrement dit, vous pensez travailler à 5 % de risque, et vous êtes en réalité à plus d’une chance sur cinq de célébrer une illusion.
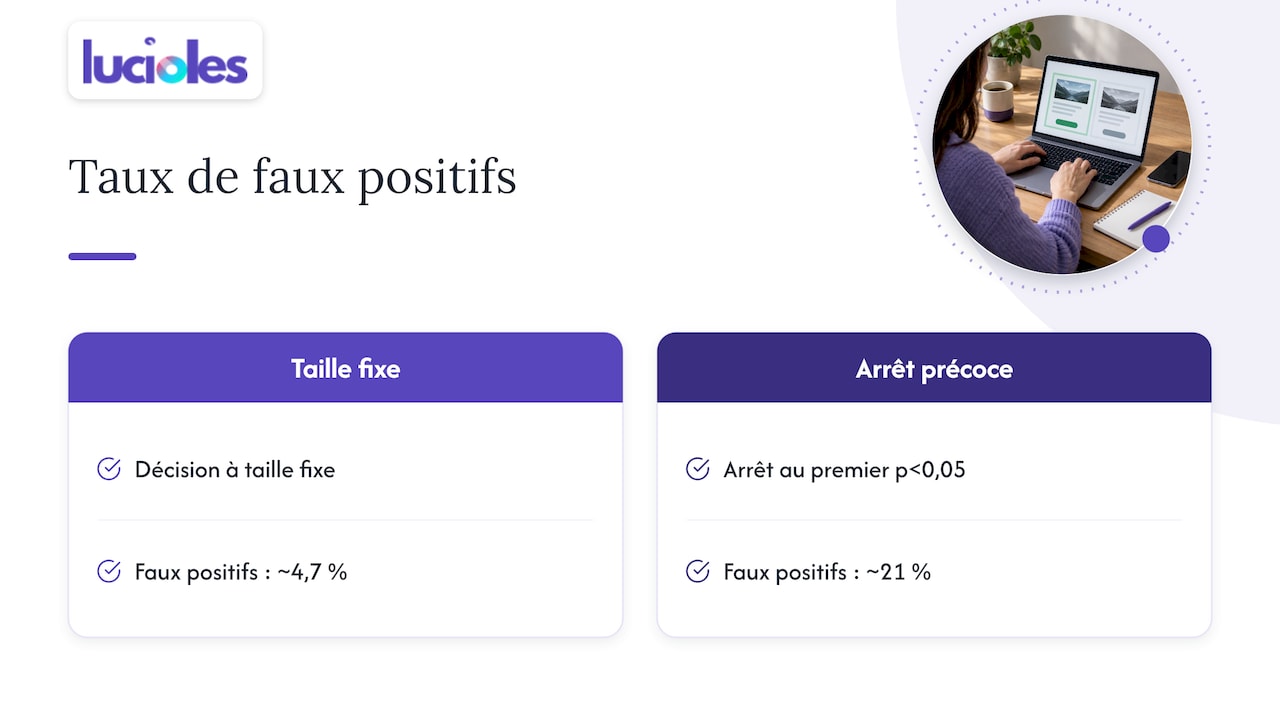
La mécanique est simple : arrêter un test dès que la p-value passe sous 0,05 transforme un test à horizon fixe en une succession d’analyses, ce qui augmente le risque de faux positifs. La revue publiée dans The American Statistician souligne d’ailleurs que la forte dépendance aux p-values dans les expériences en ligne expose les équipes aux mauvaises interprétations.
Deux façons saines de procéder
- Test à horizon fixe : vous calculez l’échantillon et la durée avant le lancement, vous ne tranchez qu’à la fin, quoi que le tableau de bord affiche entre-temps.
- Méthode séquentielle valide : si vous devez surveiller en continu, utilisez une règle d’arrêt pré-enregistrée ou des p-values conçues pour cela, comme celles que décrit l’approche de Wish.
Notre article sur la durée d’un test A/B explique comment choisir la fenêtre, notamment pour couvrir des cycles hebdomadaires complets.
Calculer l’échantillon et la durée avant de lancer
La taille d’échantillon se calcule à partir de quatre ingrédients : le taux de référence, l’effet que vous voulez détecter, le niveau alpha et la puissance statistique. La puissance est la probabilité de détecter un effet qui existe vraiment. On vise couramment 80 %.
La méthode, telle que décrite dans la littérature académique, tient en quatre étapes :
- Fixer une durée cible.
- Estimer les paramètres nécessaires avec des données historiques de même durée.
- Calculer le nombre d’utilisateurs requis.
- Si votre trafic est insuffisant, allonger la durée et refaire le calcul.
Les leviers qui font varier l’échantillon
| Paramètre | Si vous le faites bouger | Effet sur l’échantillon requis |
|---|---|---|
| Effet minimal détectable | Plus petit | Il augmente fortement |
| Taux de conversion de référence | Plus bas | Il augmente |
| Puissance | Plus élevée | Il augmente |
| Alpha | Plus strict (0,01 au lieu de 0,05) | Il augmente |
La leçon pratique : un petit site à faible trafic ne peut pas détecter de petites différences. Il vaut mieux tester des changements ambitieux (offre, proposition de valeur, parcours) que des micro-variations de couleur de bouton. Si votre audience est limitée, le guide de la taille d’échantillon et de la priorisation vous aide à choisir les tests qui valent le trafic qu’ils consomment.
Le test A/A : vérifier que votre outil ne vous ment pas
Avant de faire confiance à vos résultats, vous pouvez comparer deux versions identiques. Un test A/A sert de contrôle de l’instrumentation et du taux de faux positifs : il ne devrait normalement révéler aucune différence réelle entre les groupes, même si un seuil de 5 % peut occasionnellement produire un signal par hasard.
Si vos tests A/A déclarent régulièrement un gagnant bien plus souvent qu’une fois sur vingt, cherchez du côté du tracking, de la répartition du trafic ou de la règle d’arrêt.
Perspective : notre façon de rendre un test décisionnel
Chez Lucioles, nous voyons le même schéma chez beaucoup d’équipes : un test « significatif » à J+4, une variante déployée, puis aucun effet visible dans le chiffre d’affaires trois mois plus tard. Le problème n’est presque jamais l’outil. C’est l’absence de règle posée avant le lancement.
Notre approche part d’ailleurs de l’autre bout : avant de tester, nous cherchons à comprendre les émotions et les comportements des visiteurs. Nous associons neuromarketing, UX et neuroergonomie pour formuler des hypothèses qui ont une vraie raison de fonctionner. Un Neuropersona© bien construit réduit le nombre de tests au hasard, donc le trafic gaspillé, donc le temps pour atteindre une significativité exploitable.
Notre conviction : un A/B test n’est pas un jeu de hasard avec un voyant vert. C’est une décision d’investissement, avec un échantillon calculé, une durée fixée, un effet minimal exprimé en euros et une lecture de l’intervalle de confiance. Quand ces quatre éléments sont posés, la significativité devient un outil de pilotage fiable, et non un feu d’artifice trompeur.
Vincent
Votre check-list avant de déclarer un gagnant
- ✅ L’hypothèse et l’indicateur principal étaient écrits avant le lancement.
- ✅ L’échantillon requis est atteint, et la durée couvre des cycles complets de semaines.
- ✅ Vous n’avez pas décidé sur un coup d’œil intermédiaire.
- ✅ La p-value est sous le seuil fixé à l’avance, et l’intervalle de confiance exclut zéro.
- ✅ L’extrémité basse de l’intervalle reste rentable en euros.
- ✅ Le résultat tient sur les segments qui pèsent dans votre chiffre d’affaires.
- ✅ Le tracking a été contrôlé (un test A/A en cas de doute).
Si vous testez un site e-commerce, la méthode pour lancer votre premier test A/B cette semaine applique ces principes pas à pas. Pour cadrer l’ensemble d’un programme, la stratégie A/B testing montre comment enchaîner les tests sans vous disperser.
Passer de la théorie à des tests qui rapportent
Savoir lire une p-value est utile. Savoir quoi tester l’est encore plus. C’est le cœur de notre accompagnement : analyser vos parcours clients, repérer les frictions, puis prioriser les hypothèses qui ont le plus de chances de faire bouger vos conversions.
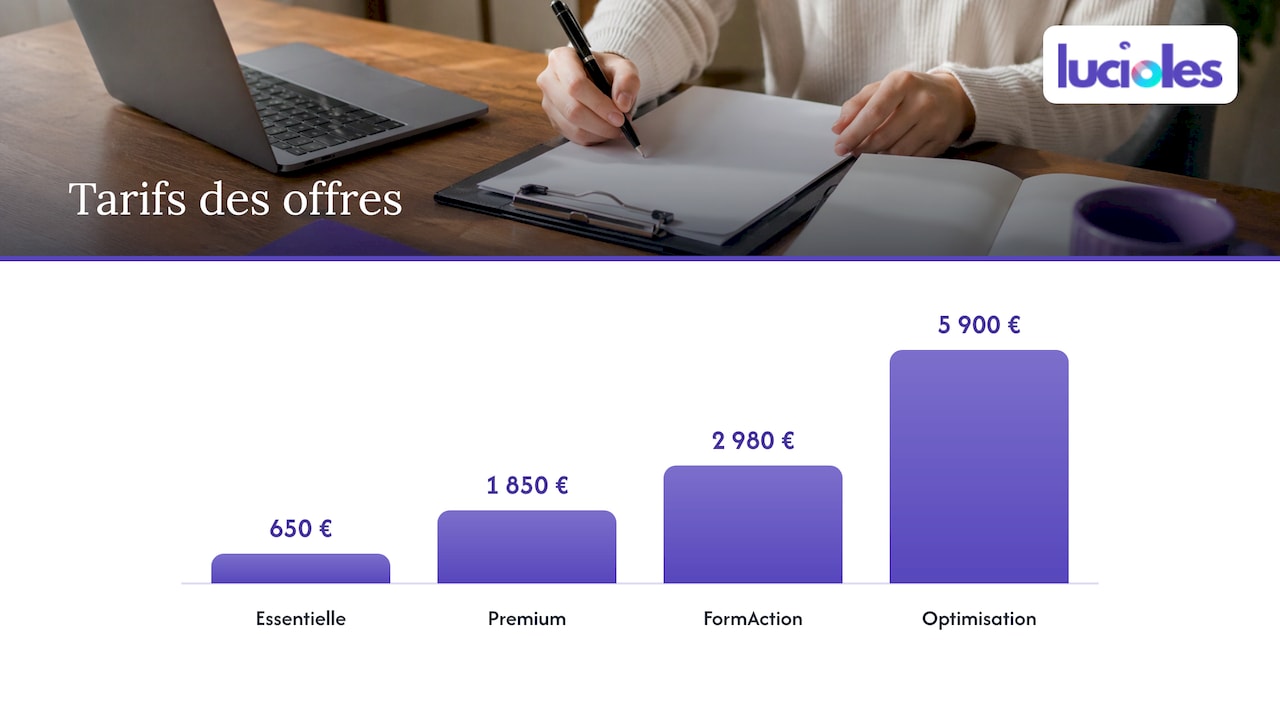
Notre offre UX et parcours clients comprend un audit, un accompagnement et une formule Optimisation à 5 900 € (prestation ponctuelle). Si vous voulez d’abord clarifier qui sont vos visiteurs et ce qui les motive, nos Neuropersona© sont proposés à partir de trois formules : Essentielle à 650 €, Premium à 1 850 € et FormAction à 2 980 €.
Vous voulez des tests dont les résultats se traduisent en euros ? Parlez-nous de votre site et de votre trafic, nous vous dirons quels tests valent la peine d’être lancés.
FAQ
Quel niveau de significativité faut-il viser pour un A/B test ?
Le standard est un seuil alpha de 0,05, soit 95 % de confiance, utilisé par exemple par Firebase A/B Testing. Vous pouvez être plus strict (0,01) pour une décision lourde ou difficile à annuler, mais l’échantillon requis augmente. L’essentiel est de fixer ce seuil avant le test.
Que faire si mon test n’atteint jamais la significativité ?
Vérifiez d’abord que l’échantillon prévu est atteint. Si oui, l’effet est probablement trop faible pour être détecté avec votre trafic. Allongez la durée, comme le recommande la méthode de calcul d’échantillon, ou testez un changement plus ambitieux. Un test non concluant vous apprend aussi qu’un levier n’est pas prioritaire.
Quelle différence entre significativité et intervalle de confiance ?
La significativité répond par oui ou non : l’écart dépasse-t-il le bruit attendu ? L’intervalle de confiance donne la fourchette plausible de l’écart réel. Il apporte donc l’information la plus utile pour décider : il montre à la fois si l’effet est probable et s’il est assez grand pour compter.
Peut-on regarder les résultats en cours de test ?
Oui, pour surveiller la qualité du tracking, mais pas pour décider. Décider au premier signal vert fait grimper le risque de faux positif : dans la simulation de Wish, d’environ 4,7 % à environ 21 %. Si vous devez décider en cours de route, utilisez une méthode séquentielle conçue pour cela.
Faut-il un test t ou un test z pour mon A/B test ?
Pour un taux de conversion (converti ou non), on utilise un test z de proportions. Pour une variable continue comme le revenu par visiteur, un test t à variances inégales. Votre outil choisit généralement le bon test, mais connaître la logique vous aide à contrôler ce qu’il affiche.
Sources
- About Firebase A/B tests, Firebase A/B Testing
- Qu’est-ce que le test A/A ? Adobe Target
- Wish Tackles Peeking with Always Valid p-values, Towards Data Science
- Statistical Challenges in Online Controlled Experiments, The American Statistician
- A/B Testing: A Systematic Literature Review
- All about sample-size calculations for A/B testing
- What Is a T-Test? Compare Survey Results With Confidence, SurveyMonkey
